Защо Google не индексира сайт или страници?
Когато Google не индексира сайт, причината невинаги е в отделна техническа настройка. Понякога съдържанието не предоставя достатъчно самостоятелна стойност, а в други случаи платформата създава противоречиви сигнали чрез canonical адреси, robots.txt, пренасочвания и XML sitemap файлове.
За да се открие действителният проблем, трябва да се провери не само отделната страница, а цялата система, чрез която Google открива, обхожда и обработва съдържанието.
Важно е да се направи едно разграничение: техническата достъпност прави страницата допустима за индексиране, но не гарантира, че Google ще я включи в индекса. Дори URL адресът да връща HTTP 200, да не е блокиран и да няма директива noindex, Google може да реши да не го индексира.
1. Защо Google не индексира сайта, въпреки че е достъпен
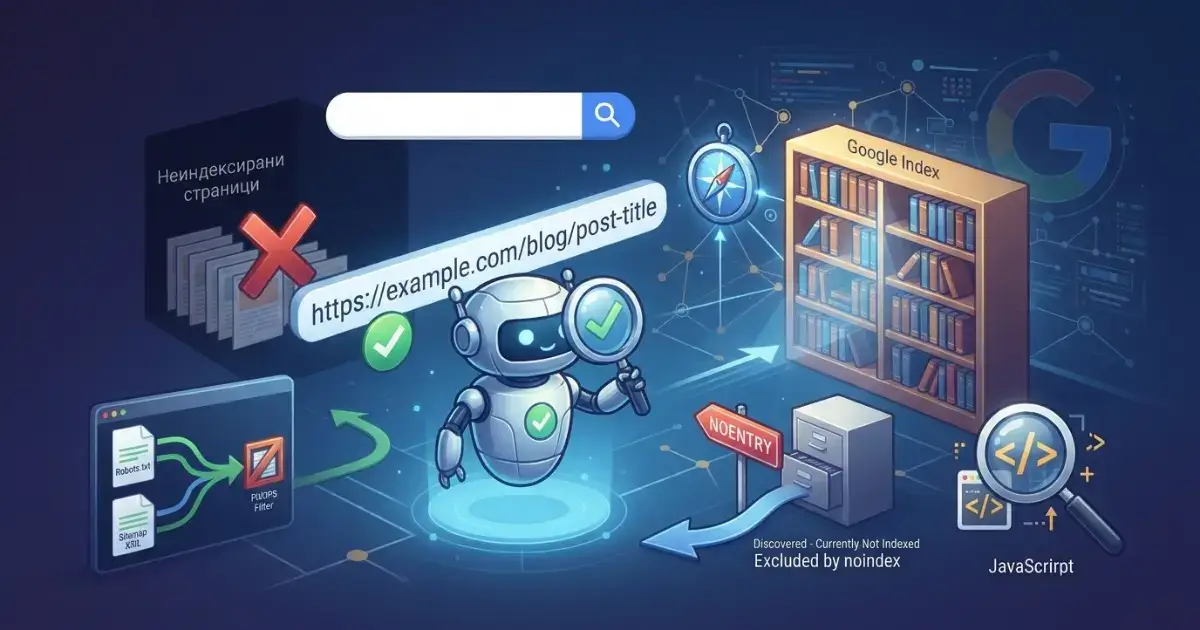
Google не е длъжен да индексира всеки открит URL адрес. Търсачката първо трябва да открие страницата, след това да може да я обходи и обработи, а накрая да прецени дали тя трябва да присъства в индекса.
Това са различни етапи и проблем във всеки от тях може да доведе до липса на видимост в резултатите.
Според техническите изисквания на Google за включване в Search страницата трябва да отговаря на три основни условия:
- Googlebot да има достъп до нея.
- Сървърът да връща успешен HTTP статус 200.
- Страницата да съдържа индексируемо съдържание.
Изпълнението на тези условия обаче не гарантира индексиране. Google изрично уточнява, че не всяка обработена страница се включва в индекса.
Най-честите причини за проблеми са:
- Съдържанието е недостатъчно полезно, оригинално или разграничимо от други публикации.
- Google не може да открие важните URL адреси чрез вътрешните връзки или sitemap.
- Robots.txt блокира обхождането на важни части от сайта.
- Meta robots или X-Robots-Tag забраняват индексирането.
- Canonical адресите, пренасочванията и sitemap подават противоречиви сигнали.
- Сървърът връща грешки или страниците са нестабилно достъпни.
- JavaScript не визуализира правилно основното съдържание.
- Сайтът генерира множество сходни, дублиращи се или малко полезни URL адреси.
В Google Search Console първата проверка трябва да бъде в отчета Индексиране на страници (Page indexing). Той показва как Google обработва URL адресите и кои от тях са включени или изключени от индекса.
Особено важно е да се разграничат следните ситуации:
| Състояние в Google Search Console | Какво означава |
|---|---|
Discovered – currently not indexed |
Google е открил URL адреса, но все още не го е обходил. |
Crawled – currently not indexed |
Google е обходил страницата, но не я е включил в индекса. |
Blocked by robots.txt |
Обхождането е блокирано от правилата в robots.txt. |
Excluded by noindex |
Открита е директива, която забранява индексирането. |
Duplicate without user-selected canonical |
Google е открил дублиране, без сайтът да е посочил предпочитан canonical адрес. |
Duplicate, Google chose different canonical than user |
Google е избрал различен canonical адрес от зададения от собственика. |
Тези статуси не са взаимозаменяеми. Например при "Discovered - currently not indexed" проблемът може да е свързан с откриването и приоритизирането на URL адреса.
При "Crawled - currently not indexed" Google вече е посетил страницата, затова трябва да се анализират съдържанието, дублирането и сигналите за canonical.
Не приемайте автоматично, че всеки неиндексиран URL е грешка. Някои адреси изобщо не трябва да присъстват в индекса - например вътрешни резултати от търсене, определени филтри или страници с дублиращо се съдържание.
2. Съдържанието може да е причината Google да не индексира страниците
Една страница може да бъде технически изрядна, но да не бъде включена в индекса, ако не предоставя достатъчно основание да бъде представена като самостоятелен резултат в търсенето.
Това се случва при публикации, които формално покриват дадена ключова дума, но повтарят информация, която вече присъства в множество други сайтове. Добавянето на още текст, заглавия и ключови думи невинаги променя ситуацията.
При оценката на съдържанието трябва да се търси реална информационна стойност:
- Дава ли страницата конкретен отговор на въпроса на посетителя?
- Съдържа ли оригинален анализ, практически опит или полезни примери?
- Разглежда ли темата достатъчно задълбочено?
- Предоставя ли информация, която липсва в останалите резултати?
- Има ли проверими факти и надеждни източници?
- Различава ли се съществено от останалите публикации на същия сайт?
Особено внимание заслужават сайтовете с голям брой публикации, създадени по сходен шаблон. Ако десетки страници се различават основно по ключовата дума, но предоставят почти еднакви обяснения, реалната им самостоятелна стойност може да бъде ограничена.
Полезното съдържание не се измерва с броя на думите, а с информацията, която читателят получава.
Това е и една от причините да не препоръчвам механично разширяване на статии. По-добре е да се премахнат повтарящи се обяснения и да се добавят конкретни данни, анализ, примери и решения, отколкото публикацията просто да стане по-дълга.
Какво показва практическият опит защо Google не индексира сайт
При работа по съдържанието на сайтове съм наблюдавал случаи, в които преработката на публикации по насоките на Google за полезно и надеждно съдържание е последвана от възстановяване на видимостта им.
В един от тези случаи след преработка и повторно подаване за индексиране страниците отново започнаха да се появяват в резултатите в рамките на два дни.
Това е конкретно наблюдение от практиката ми, а не универсален срок или доказателство, че повторното подаване само по себе си е причинило промяната. За да се установи причинно-следствена връзка, трябва да се проследят и останалите промени по сайта, обхождането и данните в Search Console.
Изводът е друг: когато Google е обходил дадена страница, но не я е индексирал, не бива автоматично да се търси проблем в robots.txt или sitemap. Съдържанието също трябва да бъде оценено.
Това съответства на насоките на Google за създаване на полезно, надеждно и ориентирано към хората съдържание. В тях се обръща внимание на оригиналността, пълнотата, експертния опит и допълнителната стойност спрямо други публикации.
3. Технически проблеми в платформата: robots.txt, sitemap и canonical
При някои сайтове проблемът с индексирането не произтича от самото съдържание, а от начина, по който платформата управлява техническите сигнали към търсачките.
Това се среща при специфични CMS системи, затворени платформи, индивидуални разработки и сайтове, при които различни компоненти управляват URL адресите, пренасочванията и метаданните.
В практиката е важно да се провери не само дали всяка настройка съществува, а дали всички настройки работят съгласувано.
Canonical адреси с www и без www
Един сайт може да бъде достъпен през няколко варианта на домейна:
- https://www.example.com
- https://example.com
- http://www.example.com
- http://example.com
За Google това са различни URL адреси. Ако сайтът предоставя еднакво съдържание през всички варианти, трябва да има последователен начин за обединяването им.
Обикновено се избира една предпочитана версия - например HTTPS без www. Останалите варианти се пренасочват към нея с постоянни пренасочвания.
След това трябва да се проверят още няколко места:
- Canonical таговете в HTML кода.
- URL адресите във вътрешните връзки.
- Адресите в XML sitemap.
- Пренасочванията на сървърно ниво.
- Canonical адресът, избран от Google.
Проблем възниква, когато тези елементи не са съгласувани. Например сайтът пренасочва www към версията без www, но canonical таговете продължават да посочват www адреси, а sitemap съдържа смесени варианти.
Самото наличие на www не е проблем. Важното е избраната версия да се използва последователно.
Неправилно форматиран или недостъпен robots.txt
Файлът robots.txt се намира в основната директория на съответния хост и съдържа правила за обхождане на URL адреси от съвместимите роботи.
Пример за базова конфигурация:
User-agent: *

Disallow: /admin/

Sitemap: https://example.com/sitemap.xml
При проверката трябва да се установи:
- Дали файлът е достъпен на правилния адрес.
- Дали сървърът връща подходящ HTTP отговор.
- Дали директивите са изписани правилно.
- Дали няма правило, което блокира важни страници или ресурси.
- Дали посоченият sitemap адрес е правилен.
Важно уточнение: интервалите сами по себе си не са грешка. Robots.txt използва интервали като разделители в директивите. Проблемът е в неправилния синтаксис, грешно изписаните правила или неподходящото им разположение.
Също така трябва да се разграничат различните HTTP отговори при заявка към robots.txt:
| HTTP отговор | Поведение на Google |
|---|---|
| 2xx | Google прочита и обработва предоставените правила. |
| 3xx | Google следва ограничен брой пренасочвания; при прекалено дълга верига може да третира файла като недостъпен. |
| 4xx* | Google приема, че няма валиден robots.txt и няма ограничения за обхождане. |
| 5xx | Google временно спира обхождането, докато се опитва да получи файла отново, като може да използва последната успешно получена версия. |
* Изключение: HTTP 429 се обработва като сигнал за претоварване и не попада в общото поведение за останалите 4xx отговори.
Това разграничение е важно, защото твърдението, че всеки недостъпен robots.txt блокира сайта, е неточно. Поведението зависи от конкретния сървърен отговор.
Има и още една често срещана грешка: използването на robots.txt като средство за забрана на индексиране.
Robots.txt контролира обхождането, а не гарантира премахване на URL адреса от индекса. Ако Google не може да обходи страницата, той може да открие адреса от други връзки и да го покаже без съдържанието му. За забрана на индексиране се използва noindex, но Google трябва да може да обходи страницата, за да прочете тази директива.
XML sitemap, който не може да бъде обходен
XML sitemap помага на Google да открива URL адресите, които собственикът на сайта смята за важни. Неговото наличие обаче не гарантира, че всички включени страници ще бъдат обходени или индексирани.
При технически проблеми може да се окаже, че:
- Файлът не е достъпен.
- Сървърът връща грешка.
- XML структурата е невалидна.
- Sitemap съдържа адреси с пренасочвания.
- Включени са URL адреси с noindex.
- Използват се различни версии на домейна.
- Индексният sitemap сочи към несъществуващи или недостъпни файлове.
Например платформата може да генерира sitemap с адреси от типа https://www.example.com, докато реалният сайт използва https://example.com. Ако останалите сигнали също не са съгласувани, се създава ненужна техническа сложност.
Правилният подход е sitemap да съдържа предпочитаните canonical URL адреси, които връщат успешен HTTP статус и могат да бъдат индексирани.
При големи сайтове е възможно да се използва индексен sitemap, който препраща към няколко отделни файла. Всеки от тях трябва да бъде достъпен и правилно генериран.
Как изглежда конфликт между няколко технически сигнала
Следният пример показва защо проверката на отделна настройка невинаги е достатъчна.
| Елемент | Установена конфигурация |
|---|---|
| Основен домейн | https://example.com |
| Пренасочване | www пренасочва към версията без www |
| Canonical в HTML | Посочва версията с www |
| XML sitemap | Съдържа URL адреси с www |
| Вътрешни връзки | Използват и двете версии |
| Google-selected canonical | Избран е адрес без www |
Това е примерен диагностичен сценарий, а не реален одит на конкретен сайт.
В него има противоречие между предпочитаната версия на домейна, canonical таговете, sitemap и вътрешните връзки. Специалистът трябва да установи коя версия действително трябва да бъде основна и да приведе всички сигнали в съответствие с нея.
Google използва няколко сигнала при избора на canonical URL адрес. Постоянните пренасочвания и rel="canonical" са силни сигнали, докато включването в sitemap е по-слаб сигнал. Нито един от тях самостоятелно не гарантира, че Google ще избере точно посочения от собственика адрес.
Това е причината да не се разчита само на canonical таг или на sitemap. Те трябва да бъдат част от последователна техническа конфигурация.
4. Други технически причини: сървър, noindex, JavaScript и сигурност
Освен robots.txt, sitemap и canonical съществуват и други проблеми, които могат да попречат на индексирането. Някои от тях засягат отделни страници, а други могат да повлияят върху целия сайт.
Грешки от сървъра и HTTP статуси
Google трябва да получава правилен отговор при заявка към страницата. Ако сървърът връща грешки, това може да попречи на нормалното обхождане и индексиране.
Най-важните статуси за проверка са:
- 200 OK - заявката е успешна. Това е очакваният отговор за страница, която трябва да бъде достъпна.
- 301 и 308 - постоянни пренасочвания към друг адрес.
- 302 и 307 - временни пренасочвания.
- 404 Not Found - страницата не е намерена.
- 410 Gone - ресурсът е премахнат окончателно.
- 429 Too Many Requests - сървърът ограничава заявките.
- 5xx - сървърна грешка.
Ако важни страници връщат 5xx отговори, Google може временно да намали обхождането. При продължителни проблеми URL адресите могат да отпаднат от индекса.
Проверете не само дали началната страница се зарежда, а и дали категориите, публикациите и продуктовите страници връщат правилните статуси.
Неправилно използване на noindex
Директивата noindex указва на Google да не включва съответната страница в индекса.
Тя може да бъде зададена чрез meta robots в HTML кода:
<meta name="robots" content="noindex">
Възможно е да бъде подадена и чрез HTTP заглавката X-Robots-Tag.
Проблемът често възниква след промени по сайта, миграция, работа по тестова среда или неправилна настройка на SEO плъгин.
Например разработчикът може да е активирал забрана за индексиране по време на изграждането на сайта, но тя да е останала и след публикуването му.
Проверявайте както HTML кода на страницата, така и HTTP заглавките. Не разчитайте единствено на визуалното съдържание или на настройките в административния панел.
Проблеми с JavaScript визуализирането
Някои платформи генерират основното съдържание чрез JavaScript. В браузъра на посетителя страницата може да изглежда напълно нормално, но първоначалният HTML отговор да не съдържа текста и връзките, които трябва да бъдат открити от търсачката.
Google може да изпълнява JavaScript и обработва такива страници на отделен етап. Процесът включва обхождане, визуализиране и индексиране. Това обаче не означава, че всяка JavaScript реализация работи безпроблемно.
Възможни проблеми са:
- Основното съдържание се зарежда само след потребителско действие.
- JavaScript ресурсите са блокирани или недостъпни.
- Възникват грешки при изпълнение на скриптовете.
- Вътрешните връзки се генерират по начин, който затруднява откриването им.
- Първоначалният HTML не съдържа съществена информация, а визуализирането не успява да я добави.
При подобни сайтове проверете визуализирания HTML чрез URL Inspection и теста за активна URL проверка в Search Console. Сравнете го с първоначалния HTML отговор.
Когато съдържанието е важно за органичното търсене, server-side rendering или предварителното генериране на HTML могат да осигурят по-предвидимо представяне пред търсачките.
Soft 404 и неправилно обработени премахнати страници
Soft 404 възниква, когато страницата изглежда като несъществуваща, но сървърът връща успешен HTTP статус 200.
Например URL адресът на изтрит продукт може да показва съобщение "Продуктът не е намерен", но да продължава да връща 200 OK.
За Google това създава несъответствие между съдържанието и HTTP отговора. Ако ресурсът действително не съществува, трябва да се върне подходящ статус, обикновено 404 или 410.
Не използвайте пренасочване към началната страница за всички изтрити URL адреси. Когато няма подходящ заместител, коректният отговор е по-добър от масово пренасочване към несвързано съдържание.
Ръчни мерки и проблеми със сигурността
Ръчните мерки и проблемите със сигурността трябва да се проверяват отделно от обичайните статуси за индексиране.
В Google Search Console има специални отчети:
- Manual Actions - показва дали Google е приложил ръчна мярка за нарушение на правилата си.
- Security Issues - показва установени проблеми като хакнато съдържание или други заплахи за сигурността.
Ръчната мярка не е същото като обикновено неиндексиране. Тя може да засегне определени страници или целия сайт в зависимост от нарушението.
Компрометиран сайт също може да има необичайни пренасочвания, добавени canonical тагове към външни домейни или автоматично генерирани спам страници. Затова при необясними промени в индексацията трябва да се проверят не само SEO настройките, но и сигурността на сайта.
5. Как да установите действителната причина в Google Search Console
Google Search Console е основният инструмент за проверка на начина, по който Google открива и обработва страниците. Той обаче не показва абсолютно всички технически проблеми. Затова данните от него трябва да се съпоставят с HTML кода, HTTP отговорите, sitemap и реалната конфигурация на платформата.
Препоръчвам следната последователност при техническа диагностика.
Проверете отчета Page indexing
Отворете Google Search Console и разгледайте отчета за индексиране на страниците.
Не се ограничавайте до общия брой индексирани и неиндексирани URL адреси. Проверете кои конкретни страници попадат във всяка група и дали има общ модел.
Например, ако голяма част от URL адресите са изключени поради noindex, трябва да се провери дали директивата е зададена умишлено. Ако много страници са с различен избран canonical, вероятно има проблем с дублирането или техническите сигнали.
Проверете представителни URL адреси
Изберете адреси от различни типове:
- Начална страница.
- Основни категории.
- Важни публикации.
- Продуктови страници.
- Страници, които Google не индексира.
- Страници, които са индексирани, но имат съмнителни технически сигнали.
Използвайте URL Inspection, за да проверите състоянието на всеки адрес.
Обърнете внимание на:
- Дали URL адресът е открит от Google.
- Дали е обходен.
- Кога е било последното обхождане.
- Дали обхождането е разрешено.
- Дали индексирането е разрешено.
- Какъв canonical е посочил собственикът.
- Какъв canonical е избрал Google, когато тази информация е налична.
Тези данни помагат да се установи дали проблемът е в достъпа, индексирането или избора на предпочитан URL адрес.
Проверете техническите сигнали извън Search Console
Следващата стъпка е да сравните данните с реалната конфигурация на сайта.
| Проверка | Какво трябва да установите |
|---|---|
| HTTP статус | Връща ли страницата очаквания отговор |
| Пренасочване | Води ли URL адресът към правилната версия |
| Canonical | Посочва ли предпочитания адрес |
| Meta robots | Има ли забрана за индексиране |
| X-Robots-Tag | Подадена ли е забрана чрез HTTP заглавка |
| Robots.txt | Разрешено ли е обхождането |
| XML sitemap | Съдържа ли правилните canonical URL адреси |
| Вътрешни връзки | Могат ли важните страници да бъдат открити |
| JavaScript | Показва ли се основното съдържание след визуализиране |
Не всички тези данни се показват в един екран на Search Console. Част от тях трябва да се проверят чрез браузър, инструменти за технически одит или заявка към сървъра.
Проверете дали проблемът е единичен или системен
Това е една от най-важните стъпки.
Ако една публикация не се индексира, причината може да бъде специфична за нейното съдържание или техническа реализация.
Ако обаче стотици URL адреси имат еднакъв проблем, трябва да се търси общ източник:
- Грешна настройка в CMS.
- Проблем в SEO плъгин или модул.
- Неправилно генериране на sitemap.
- Грешни правила в robots.txt.
- Неправилно зададен canonical шаблон.
- Проблем със сървърната конфигурация.
- Дублиране, създавано от филтри и параметри.
Точно тук се вижда разликата между проверката на една страница и техническия анализ на целия сайт. Затова при системни проблеми правя пълен SEO одит на сайт, а не проверка на отделни URL адреси.
6. Кога платформата пречи и Google не индексира сайт има ли смисъл от миграция
Понякога техническите проблеми се повтарят, защото платформата не предоставя достатъчно контрол върху основните SEO настройки. В такива случаи всяка корекция изисква намеса на разработчик, а някои ограничения могат да бъдат заложени в самата система.
Това не означава, че всяка платформа извън WordPress или Magento е неподходяща за SEO. Много сайтове, изградени върху различни технологии, се индексират и класират успешно. Важният въпрос е дали системата позволява правилно управление на техническите сигнали.
Кои ограничения на платформата са съществени
Преди да се препоръча миграция, трябва да се установи дали настоящата система позволява:
- Избор и последователно използване на предпочитан домейн.
- Управление на canonical адресите.
- Коректни 301 и 302 пренасочвания.
- Редактиране или генериране на robots.txt.
- Създаване на валидни XML sitemap файлове.
- Управление на meta robots и X-Robots-Tag.
- Контрол върху URL структурата.
- Индексиране на важните категории и продуктови страници.
- Премахване или ограничаване на ненужните параметри и филтри.
Ако тези възможности липсват или работят непредвидимо, техническата оптимизация може да се превърне в постоянна борба с ограниченията на платформата.
WordPress за корпоративни сайтове и съдържателни проекти
WordPress предоставя възможности за управление на URL адресите, метаданните, canonical таговете, пренасочванията и XML sitemap файловете.
С правилна конфигурация специалистът може да контролира основните технически SEO настройки чрез административния панел и подходящи разширения.
Това го прави практичен избор за корпоративни сайтове, блогове, сайтове за услуги и проекти, при които съдържанието е основна част от органичното присъствие.
Но WordPress също може да бъде конфигуриран неправилно. Конфликт между SEO плъгини, грешни настройки за индексиране, неправилни пренасочвания или некачествена разработка могат да доведат до същите проблеми.
Magento за онлайн магазини със сложна структура
Magento е платформа, предназначена за електронна търговия и по-сложни продуктови структури.
При правилна реализация могат да се управляват категории, продуктови варианти, canonical адреси, филтри, параметри и sitemap файлове.
Това е особено важно при големи магазини, в които комбинациите от филтри и характеристики могат да генерират множество URL адреси.
Magento обаче изисква добра техническа конфигурация и поддръжка. Неправилното управление на филтрите, дублираните продуктови страници и canonical сигналите може да създаде сериозни проблеми с обхождането и индексирането.
Кога миграцията е по-разумна от поредната корекция
Миграцията има смисъл, когато ограниченията на платформата са системни и не могат да бъдат отстранени надеждно.
Например:
- Не може да се зададе правилен canonical адрес.
- Sitemap се генерира автоматично с неправилни URL адреси.
- Robots.txt не може да бъде редактиран или се презаписва от системата.
- Пренасочванията не могат да бъдат управлявани надеждно.
- Платформата генерира множество ненужни URL варианти.
- Необходимите SEO промени изискват постоянна намеса на разработчик.
- Разходите за поддръжка и корекции са по-високи от тези за преминаване към по-подходяща система.
Не препоръчвам миграция само защото сайтът не се индексира. Първо трябва да се докаже, че причината е в ограниченията на платформата, а не в грешна конфигурация, съдържание или сървър.
При миграция трябва да се подготвят карта на старите и новите URL адреси, постоянни пренасочвания, нови sitemap файлове, правилни canonical сигнали и план за наблюдение след пускането на новия сайт.
Смяната на платформата не гарантира индексиране. Тя има смисъл, когато премахва конкретни технически ограничения, които пречат на правилното управление на сайта.
7. Какво да направите, ако Google не индексира сайт дълго време
Ако след проверките проблемът остава, не изпращайте многократно едни и същи URL адреси за индексиране с очакването, че това ще промени резултата. Първо трябва да се отстрани причината, а след това да се даде възможност на Google да обходи и оцени страниците отново.
Практическият подход е следният:
- Проверете отчета Page indexing и определете кои URL адреси са засегнати.
- Установете дали проблемът е в откриването, обхождането, индексирането или canonical избора.
- Проверете robots.txt, meta robots, X-Robots-Tag и HTTP статусите.
- Сравнете canonical адресите, пренасочванията, вътрешните връзки и sitemap.
- Проверете съдържанието и дали страниците имат самостоятелна информационна стойност.
- Проверете сървърните грешки, JavaScript визуализирането и отчетите за сигурност.
- Отстранете системните проблеми в платформата, ако има такива.
- След корекциите използвайте URL Inspection за повторна проверка и заявка за индексиране на най-важните страници.
Не очаквайте всички URL адреси да бъдат обработени едновременно. Google определя кога да обходи страниците и дали да ги включи в индекса. Sitemap и заявката за индексиране помагат за откриването и повторната обработка, но не гарантират резултат.
Най-важното е да не се смесват два различни проблема: сайтът да не може да бъде индексиран поради технически ограничения и сайтът да не получава желаната видимост, защото съдържанието му не предоставя достатъчна стойност. Факторите за класиране на сайт в Google, след като страницата вече е в индекса, съм разгледал отделно.
В първия случай трябва да се отстранят пречките пред обхождането и индексирането. Във втория е необходима работа по съдържанието, структурата и полезността на страниците.
Понякога решението е в една настройка. В други случаи се налага преработка на съдържанието, корекция на платформата или миграция към друга система. Правилният подход започва с установяване на действителната причина, а не с поредната промяна на настройка на случаен принцип.
Официални източници и техническа документация
- Google Search Essentials - технически изисквания за индексиране
- Google Search Central - полезно и надеждно съдържание
- Google Search Central - отчет за грешки при обхождането
- Google Search Central - избор на canonical URL
- Google Search Central - отстраняване на проблеми с canonical
- Google Crawling Infrastructure - обработка на robots.txt
- Google Search Central - създаване и изпращане на sitemap
- Google Search Central - основи на JavaScript SEO
- Google Crawling Infrastructure - HTTP статуси и Googlebot